双 3080 从 47 到 57 tok/s:Qwen3.8-27B 调优实录,和一场 -27% 的翻车
本文最后更新于 2026年9月18日 凌晨
两张 RTX 3080 20G,跑 Qwen3.8-27B 的 Q4 量化版(17.5 GB),llama.cpp 默认配置实测 47.5 tok/s。这个数字不上不下:能用,但想到社区里单卡 3080 跑出过 69.5,就很难装作没看见。
一个晚上,四轮实验,两个配置生效、两个方案证伪。最终闲聊场景 54~57 tok/s,生产负载(JSON/代码)63~70 tok/s。过程里有一步把速度砍掉了 27%——这步最有价值,展开讲。
起点:47.5 tok/s 的默认配置
先交代硬件与软件底座:
- 2 × RTX 3080 20G(GA102,单卡带宽 760 GB/s)
- X99 平台,无 ReBAR,PCIe 带宽有限
- llama.cpp v0.4.1-dev,模型 unsloth 的 Q4_K_XL(17.5 GB 单文件)
- 默认配置:layer 切分 58,42 + MTP 投机解码 n=2
基准测试口径先钉死,否则后面所有对比都是空谈:固定 prompt,max_tokens 256~300,热测至少 3 次取均值,±2 tok/s 视为噪声。
47.5 就是这个口径下的数字。
第一刀:layer 切分换成 tensor,比例必须重调
llama.cpp 双卡有两种切分方式:layer 模式(按层切,卡间串行流水)和 tensor 模式(按张量切,卡间并行计算)。理论上 tensor 模式对 dense 模型更友好,但有个前提——模型架构得支持。
第一步不是改配置,是确认架构。从 GGUF 文件头解析出 general.architecture = qwen35。这是 Qwen3.8 系列的新架构标识,和 Flash-Next 用的 qwen4exp 是两回事。前者支持 tensor 切分,后者实测不支持。跳过这步直接切,轻则报错重则白跑一晚上。
切换结果,第一版踩了个坑:直接沿用了 layer 模式的 58,42 比例。速度确实涨了,47.5 → 51.7,但显存失衡——GPU0 吃到 18.7 GB,GPU1 只用了 12.8 GB,差了 6 GB。
tensor 模式下两张卡是并行关系,比例的语义和 layer 模式完全不同,旧比例没有迁移价值。调平到 50,50 后:
| 配置 | chat tok/s | 显存 GPU0/GPU1 |
|---|---|---|
| layer 58,42 + MTP2(基线) | 47.5 | 17.3 / 16.2 G |
| tensor 58,42 | 51.7 | 18.7 / 12.8 G |
| tensor 50,50(定稿) | 54.3~56.8 | 16.4 / 15.2 G |
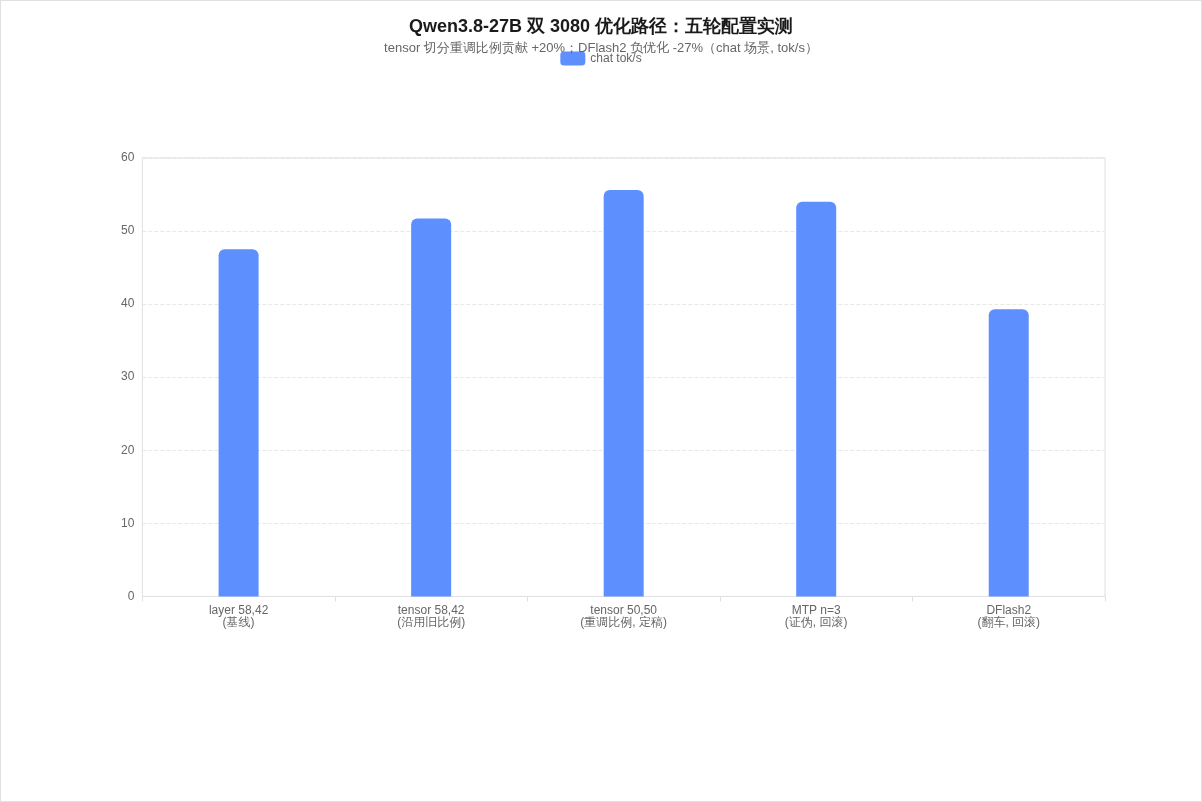
+20%,零成本,纯配置。 这是整个调优里性价比最高的一刀。
第二刀:MTP 加深到 n=3,证伪
MTP(Multi-Token Prediction)投机解码,draft 深度从 2 加到 3,理论上每次 verify 能多接受 token。实测 54.0——和 n=2 打平,在噪声范围内。
这不意外。之前在 Qwen3.6-35B MoE 上验证过同样的结论:draft 越深,verify 计算量越大。双卡 tensor 模式下,verify 的跨卡开销把多出来的接受率吃掉了。n=2 就是这套硬件的甜点。回滚。
第三刀:DFlash2,一场教科书级翻车
DFlash2 是社区热度很高的新方案:块扩散(block-diffusion)draft 模型,官方宣称 2.2 倍加速。3090 上代码场景实测 170~191 tok/s。draft 模型只有 1.1 GB,下载部署都不贵。
开思考模式不兼容,得先关——用户授权关了 thinking,切换,测。
39.3 tok/s。比 MTP n=2 慢 27%。
第一反应是测试场景偏差:官方数据全是代码场景,我测的是闲聊。好,那就做场景矩阵,四种负载各测三轮:
| 场景 | MTP n=2 | DFlash2 | 差距 |
|---|---|---|---|
| 中文闲聊 | 55.0 | 39.0 | -29% |
| Python 代码 | 66.9 | 41.4 | -38% |
| JSON 结构化 | 69.0 | 41.0 | -41% |
| 中英混合运维 | 63.2 | 41.3 | -35% |
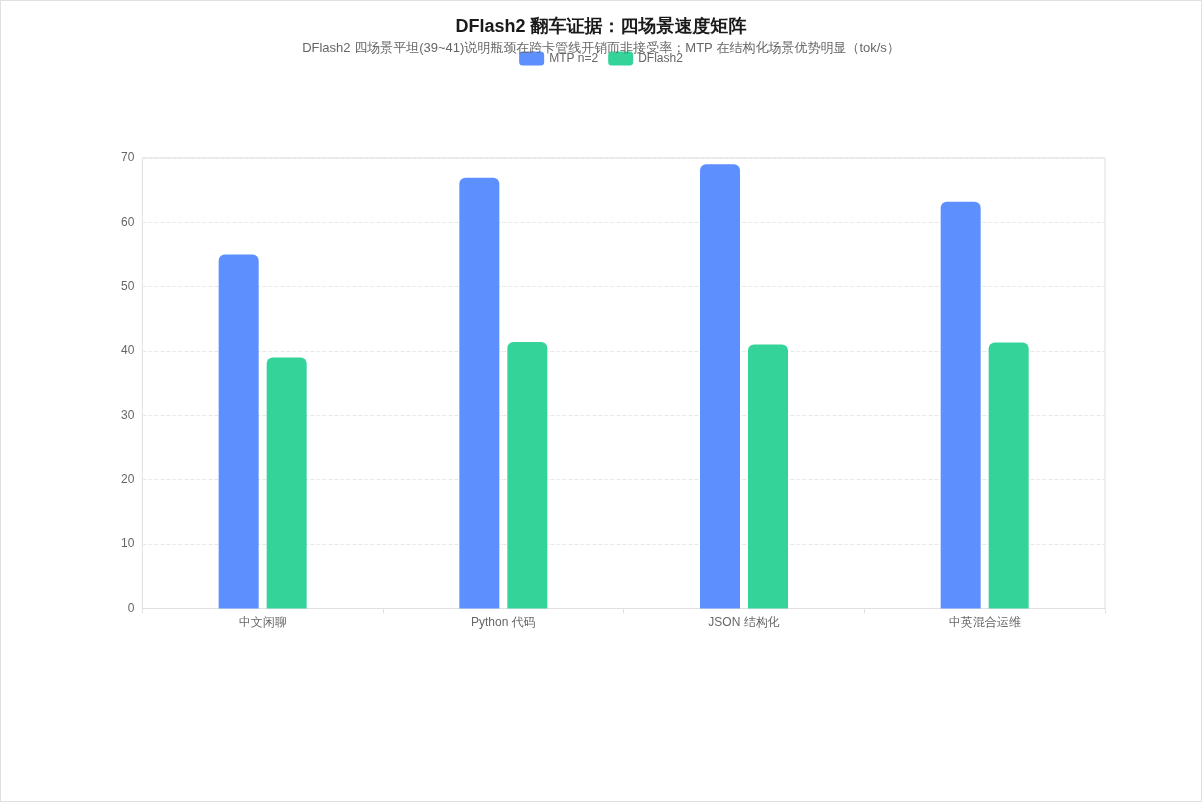
关键信号不是”慢”,是平。DFlash2 四个场景 39~41,几乎一条直线;而 MTP 在代码和 JSON 场景明显快于闲聊(接受率红利真实存在,后面细说)。
一条直线意味着瓶颈不在解码逻辑,而在每步固定的管线开销。DFlash2 的管线是:draft 模型单卡生成候选块 → 主模型双卡 verify。每一步都有一次跨卡同步。在 tensor split 双卡拓扑下,这个开销是恒定的、且大到吃掉了块扩散带来的全部收益。
查日志佐证:MTP worker 持续输出 0.55~0.90 的接受率记录;DFlash2 worker 压根没有接受率日志——它走的不是同一条验证管线。
回头看官方和社区的高分数据,成立条件一目了然:单卡、vLLM/SGLang 专用引擎、代码场景。三个条件缺一不可。我的环境双卡、llama.cpp、混合负载,三个全不满足。这不是配置没调对,是方案和拓扑不匹配。
想单卡验证?Q4_K_XL 是 17.5 GB,塞不进 20 GB 单卡(跑不动 KV cache)。双卡是硬约束,不是选择。
回滚。前后两轮实验,DFlash2 在这套硬件上的结论钉死:不可用,负优化 27~41%。
意外收获:负载类型决定真实速度
场景矩阵跑出来的另一个发现,比调优本身更有用:
评估推理速度,必须用目标负载的 prompt。
同样 MTP n=2 配置,闲聊 55.0,JSON 结构化 69.0,差 25%。原因是 MTP 的接受率对内容结构敏感:代码和 JSON 的 token 分布可预测性高,draft 命中率高。而我的生产负载恰好是 Agent 工具调用的 JSON 输出——真实生产速度比闲聊基准快 15~25%。
如果只看闲聊基准做决策,会系统性低估这套硬件在生产里的表现。
终局:57 是墙,破墙要换引擎
调优到此,闲聊 54~57 就是这套硬件 + llama.cpp 的天花板。物理原因很直白:760 GB/s × 2 的带宽,跑通用推理引擎的 dense 27B,decode 阶段是带宽受限的,配置只能榨出常数级改进。
对照社区同硬件数据(2026-09,lcz.me 论坛):
| 方案 | 硬件 | 引擎 | 速度 |
|---|---|---|---|
| 本次调优 | 双 3080 20G | llama.cpp Q4 + MTP2 | 54~57(chat)/ 69(json) |
| 社区实测 | 单卡 3080 20G | NInfer groupwise-int + MTP3 | 69.5 |
| 社区实测 | 双 3080 20G | SGLang TP2 + DFlash2 补丁 | 70 单流 |
| 社区实测 | 单卡 3090 | vLLM W4A16 + DFlash2 | 118 均值 |
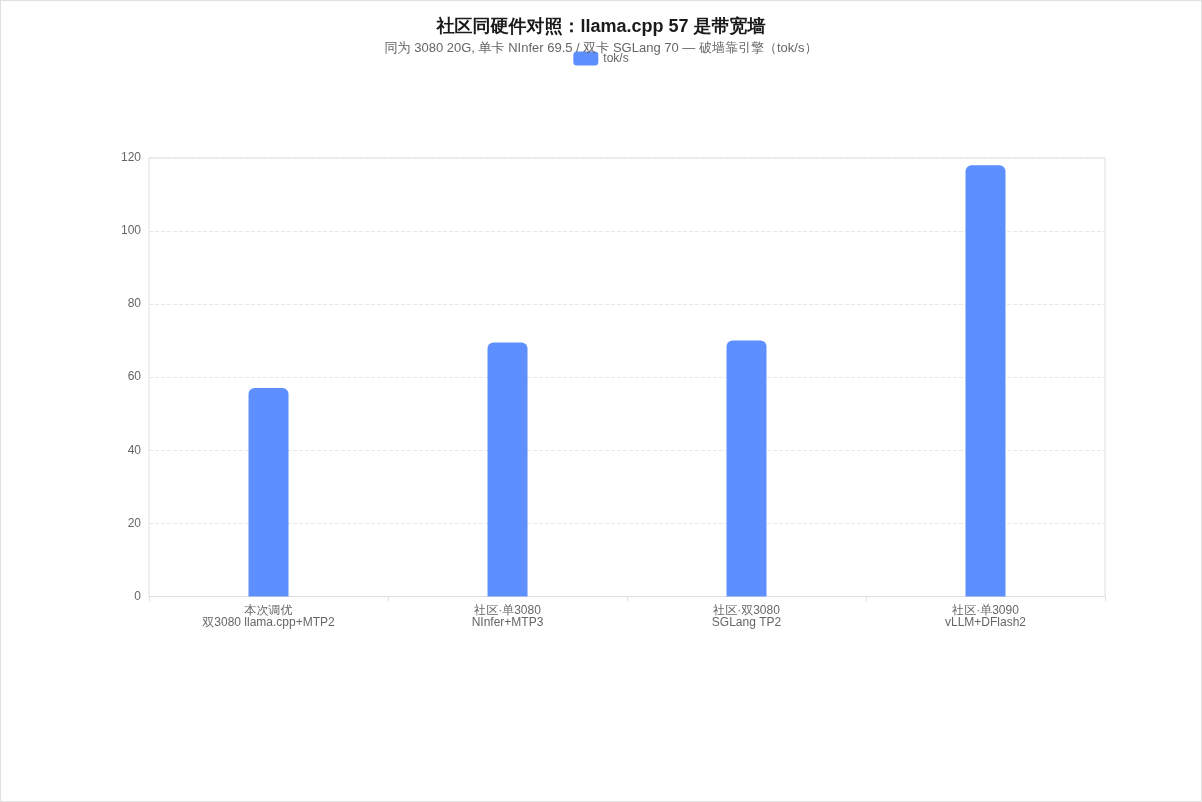
单卡 3080 跑 69.5,靠的是 groupwise 整数量化把模型压进 15.25 GB。单卡部署消除了所有跨卡开销,MTP 加深到 n=3 也不再被管线税拖累。这从反面印证了 DFlash2 翻车的归因:跨卡同步开销是双卡部署最大的隐性成本。
下一步方向已经清楚:破 70 只能换引擎——NInfer 单卡方案,或 SGLang 双卡 TP2 + 社区补丁。那是 Docker 镜像 + 新量化格式 + 适配调试的项目级工程,另开一篇再写。
复盘清单
这次实验留下的可迁移经验,按价值排序:
- 改切分模式必重调比例。tensor 和 layer 的比例语义不同,旧比例没有迁移价值,先看显存是否调平
- 负优化也要归因到底。”慢 27%”只是现象,”四场景平坦 + 无接受率日志”才指向管线开销这个根因。归因错了,回滚之后还会再踩
- 社区数据要拆条件。硬件、引擎、场景三个维度都对上才可引用,只看 headline 数字必然翻车
- 基准测试必须分场景。闲聊基准低估生产负载 15~25%,JSON/代码场景的投机解码红利是真实存在的
- 每一步都留备份。
models.ini.bak.<时间戳>_<标记>,翻车回滚 30 秒完成,全链路零损失
从 47.5 到 57,+20% 靠一个配置;剩下的差距,得靠换引擎。调优的意义就在这——把”配置能解决的”和”架构才能解决的”彻底分开。
实验环境:2×RTX 3080 20G / llama.cpp v0.4.1-dev / Qwen3.8-27B Q4_K_XL,数据均为热测 3 次以上均值。
参考文献
- llama.cpp 官方文档 — 多 GPU 切分与投机解码参数(github.com/ggml-org/llama.cpp)
- lcz.me 论坛 2026-09 实测帖:tid=1656(3090 vLLM + DFlash2)、tid=1715(3080 NInfer 69.5)、tid=1749(双 3080 SGLang TP2)
- contextstudios《Qwen3.8-27B 消费级硬件部署指南》(2026-08)— 64 层混合架构(48 Gated DeltaNet + 16 full attention)