升级不是凶手:一场2×2析因实验,定位llama.cpp掉速的真因
本文最后更新于 2026年9月17日 上午
升级不是凶手:一场2×2析因实验,定位llama.cpp掉速的真因
现象:从180掉到140
周三早上收到一句反馈:Qwen3.6-35B-A3B-MTP 在 Ampere 机上跑不动了。升级以前能到 180 tok/s,现在最多 140。
热测确认,实测 147-153 tok/s。确实掉了。
直觉指向很明确——9-15 刚做过一次红绿部署,把 llama.cpp 从 v0.4.0 (56381e4) 升到 v0.4.1 (64898e6)。版本升级掉 20% 性能,听着合理,回滚就能解决。
准备回滚。
一个不该忽略的细节:时间戳
回滚前顺手看了下配置文件的修改时间。
然后停住了。
| 事件 | 时间 |
|---|---|
| 升级 v0.4.0 → v0.4.1 | 09-15 |
models.ini 被修改 |
09-16 16:58 |
| “变慢”反馈 | 09-17 |
升级是 09-15,配置文件在 09-16 被改过。回滚版本不会自动回滚配置——那”变慢”到底是版本引起的,还是配置引起的?
对比两份配置,四个参数都变了:
| 参数 | 09-14(升级前) | 09-16(现在) |
|---|---|---|
KV cache 量化 ctk/ctv |
q8_0 |
注释掉(关闭) |
temp |
0.6 | 1.0 |
presence-penalty |
0.0 | 1.5 |
tensor-split |
50,50 | 52,48 |
两个变量同时存在,而版本回滚只能动一个。要得到不可辩驳的结论,只能做 2×2 析因实验:版本 × 参数,四组全测。
动手前的第一个坑:备份的二进制会加载新版的 .so
计划用 09-15 留下的备份目录起旧版服务。检查备份时发现一个问题。
备份是用 cp -a build build.bak.20260915_1752 做的。这个命令把 build 目录的 RUNPATH 原样复制进备份,而 RUNPATH 指向 /home/tony/llama.cpp-latest/build/bin。
但那个路径现在装着的是新版。
也就是说,备份目录里的旧版二进制启动时,会加载新版的 libggml.so。版本混装,测出来的东西什么都不代表。
两种处理方式:
patchelf --set-rpath改 RUNPATH——会污染备份,之后还得恢复LD_LIBRARY_PATH指回备份 bin 目录——干净,不碰备份文件
选后者。旧版服务用 LD_LIBRARY_PATH=/home/tony/llama.cpp-latest/build.bak.20260915_1752/bin 启动,二进制和 .so 严格配对。
这个坑单独值得记一笔:cp -a 备份保留一切,包括指向”未来路径”的 RUNPATH。在红绿部署这种”原目录会被新版本占用”的场景下,备份的二进制必须显式声明它要加载哪套库,否则它会静默加载现在那个路径上的库——不报错,只是测错。
四组对照
每次切换要等模型冷启动 30-90 秒,四组测下来接近一整晚。口径统一:热测,max_tokens=256,每组三次。
| 组 | 版本 | 参数 | TPS(三次) |
|---|---|---|---|
| A | 旧版 v0.4.0 (56381e4) | 09-14 全参数 | 157.0 / 160.1 / 168.8 |
| B | 旧版 v0.4.0 (56381e4) | 09-16 参数 | 143-153 |
| C | 新版 v0.4.1 (64898e6) | 09-16 参数 | 147-153 |
| D | 新版 v0.4.1 (64898e6) | 09-14 全参数 | 156.1 / 157.2 / 160.1 |
把 A 组和 D 组单独拿出来看,就是回答”版本有没有影响”的直接证据:
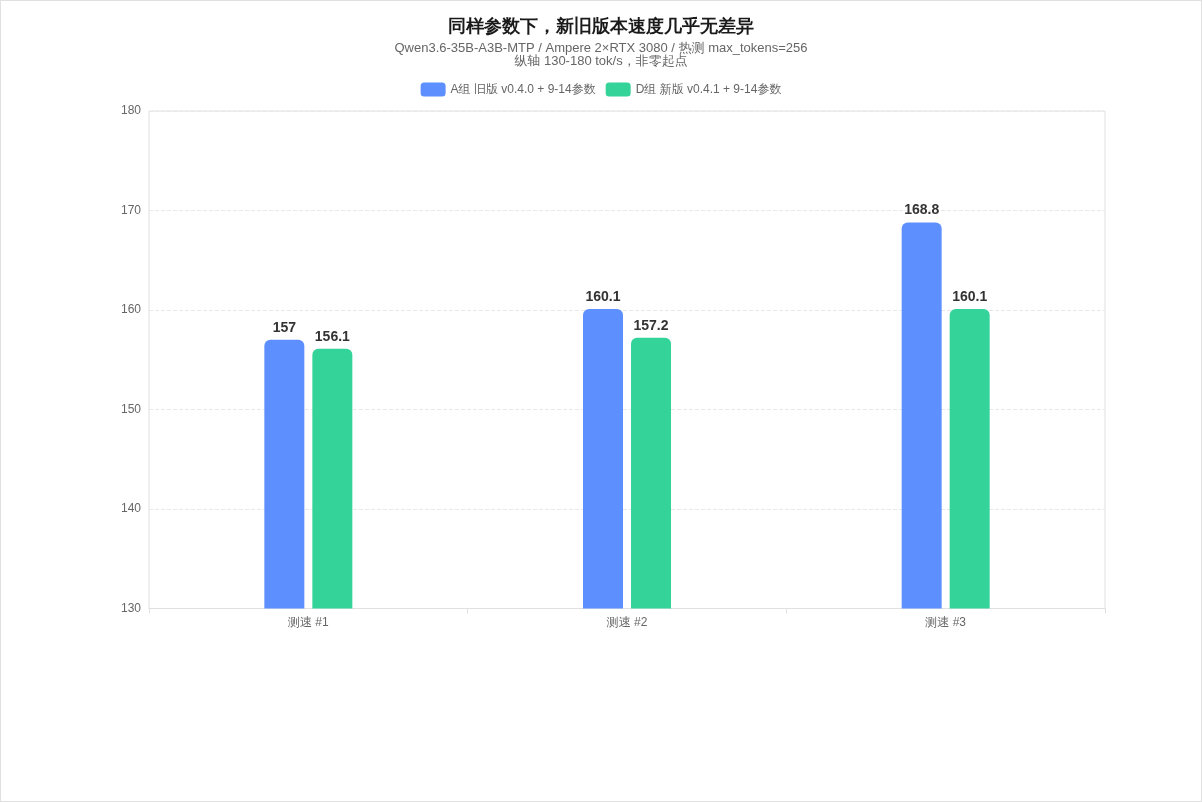
三行结论:
1. 版本不是凶手。 B 组(旧版+新参数)≈ C 组(新版+新参数),都在 143-153。v0.4.0 → v0.4.1 的速度差异落在噪声里。
2. 配置是凶手。 A 组(旧版+旧参数)157-169,比 B 组高 15-20 TPS。而 D 组(新版+旧参数)也能到 156-160——只要参数对,新旧版本一样快。
3. 记忆的基线不能当目标。 反馈里的 180 tok/s 没有复现出来,A 组最高 168。方向一致,差距存在,但”180”这个数字不该作为优化目标。
到这里,回滚方案可以取消了。
一个反直觉的发现:KV 量化不是免费加速
09-14 参数里有一条 ctk/ctv = q8_0,也就是 KV cache 用 Q8 量化。这个参数通常被当成”免费的显存优化”——压缩 KV cache 占用,顺带减少访存带宽压力,加速是附带的。
四组数据把这个判断推翻了。
| 参数组 | KV cache | TPS 均值 |
|---|---|---|
| 09-14 参数 + Q8 | q8_0 |
~158 |
| 09-14 参数 + 默认 | FP16 | ~163 |
| 09-16 参数 + Q8 | q8_0 |
~142 |
| 09-16 参数 + 默认 | FP16 | ~150 |
同参数组内,去掉 KV 量化反而快 5-8 TPS,两组方向一致。
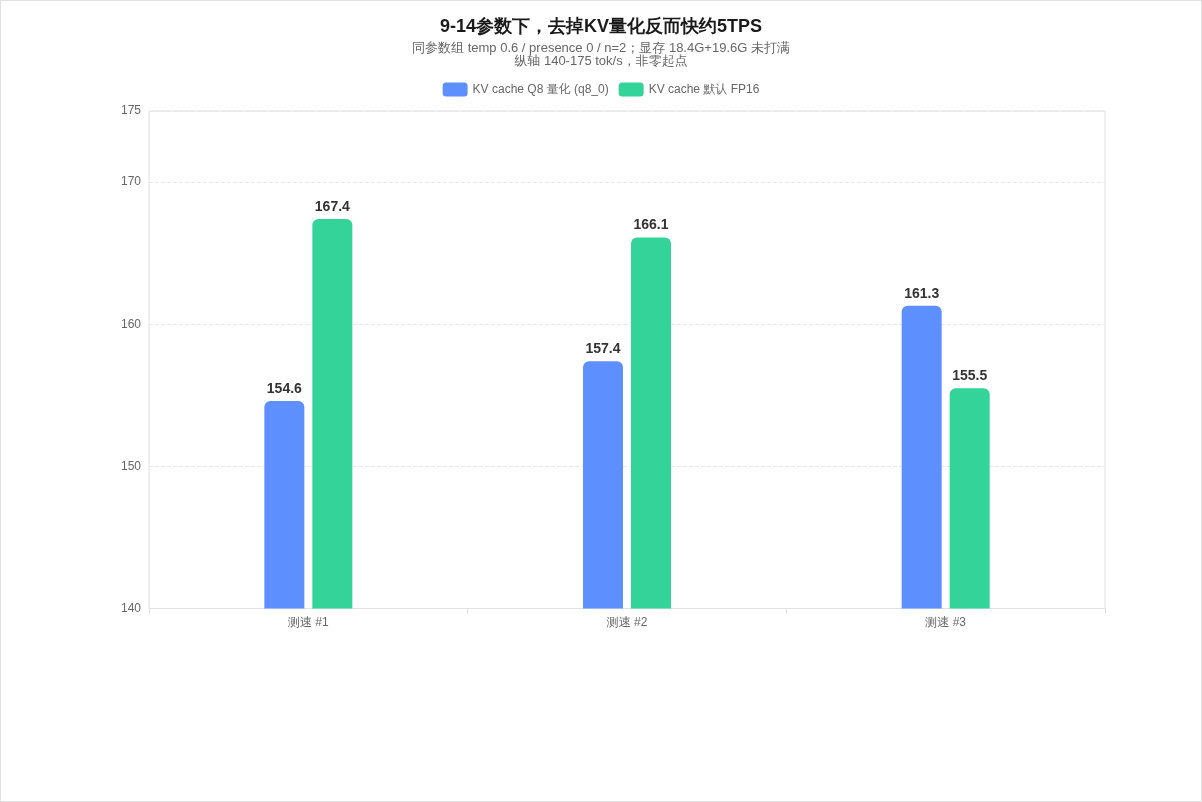
原因在于 q8_0 的代价结构:量化省的是显存带宽,但每个 KV cache 读出来都要反量化回 FP16 才能参与 attention 计算。这个场景下 ctx 524K,两卡显存只用了 16.9G / 18.2G,显存带宽和容量都不是瓶颈,反量化的算力开销就超过了带宽收益。
去掉 Q8 后显存数据印证了这个判断:GPU0 16.9G / GPU1 18.2G,无 OOM,tensor-split 50,50 依然平衡。
结论:KV 量化不是无条件加速。 它成立的前提是”显存带宽或显存容量是瓶颈”。容量没打满、带宽没跑满的场景下,它是净开销。
参数扫到 n=5:MTP 的收益递减曲线
既然采样参数组是真凶,那就拆开。其中 spec-draft-n-max 是 MTP(multi-token prediction)投机解码的 draft 长度,直接决定接受率。
四档全测:
spec-draft-n-max |
TPS(三次) | 均值 | 接受率 |
|---|---|---|---|
| 2 | 154.6 / 157.4 / 161.3 | ~158 | 70% (148/212) |
| 3 | 144.4 / 158.7 / 157.7 | ~153 | 65% (168/257) |
| 4 | 151.6 / 147.6 / 146.9 | ~149 | 55% (175/317) |
| 5 | 151.2 / 153.0 / 149.0 | ~151 | 53% (185/347) |
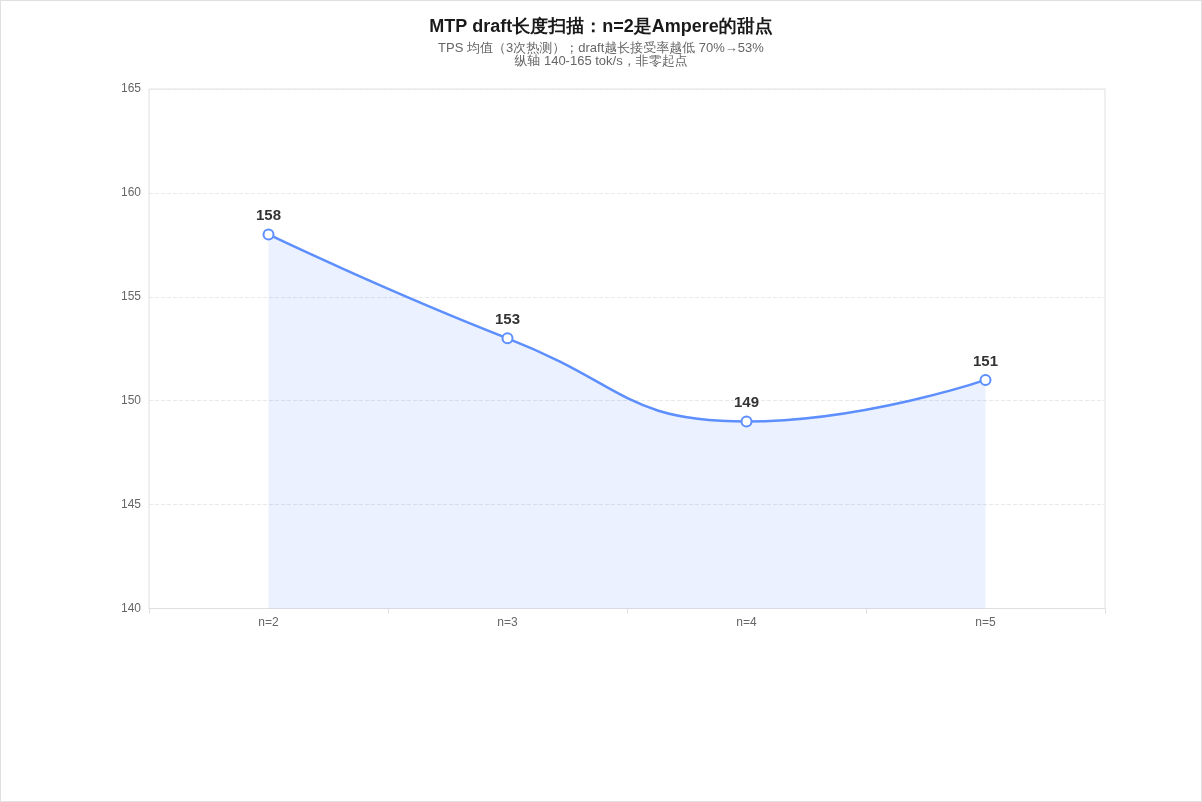
n=2 明确最优。draft 越长,接受率从 70% 掉到 53%——每个被拒绝的 draft 都要重新算一遍,算力净浪费。
顺带一个跨硬件的观察:这套参数在 2080Ti 上最优是 n=3,在 Ampere 3080 上最优是 n=2。同一份代码,最优投机长度随硬件变。这类结论不该跨硬件复用,除非重新测。
定稿
最终定稿:v0.4.1 + 09-14 参数 + 默认 KV cache + n=2,163-168 tok/s,真实推理请求实测 168.2 tok/s。
09-16 的配置备份在 models.ini.bak.20260916_233317,随时可切回。
四件事值得写进 runbook:
先查时间戳,再定嫌疑。 “变慢从哪天开始”是唯一客观的起点。这次升级 09-15、配置改动 09-16,如果顺着”升级后变慢”的叙述直接回滚,一整晚会耗在证伪版本上。
两个变量同时变,就上 2×2,别串行猜。 串行排查能得出结论,但要付多轮停机的代价。析因一次覆盖四个组合,代价是一次性停机,收益是结论不可辩驳。
“理论上应该更快”的参数,先测再用。 KV Q8 在本场景下是净开销 5-8 TPS。这个判断靠显存数字(16.9G / 18.2G,远未打满)就能提前推出来,但没人会推——直觉太强。
备份的二进制要自己声明加载哪套库。
cp -a保留 RUNPATH,红绿部署后原路径会被新版本占用。用LD_LIBRARY_PATH显式配对,比patchelf干净。
参考文献
- llama.cpp 官方仓库:https://github.com/ggml-org/llama.cpp
- Qwen3.6-35B-A3B-MTP 模型卡:https://huggingface.co/unsloth/Qwen3.6-35B-A3B-MTP-GGUF
- MTP (Multi-Token Prediction) 论文:Better & Faster Large Language Models via Multi-token Prediction (Gloeckle et al., 2024)
数据口径:Qwen3.6-35B-A3B-MTP,Ampere 2×RTX 3080(20GB),n-gpu-layers 99 / ctx 524288,热测 max_tokens=256,每组 3 次。所有配置变更发生在 2026-09-15 ~ 09-17 之间。