双 2080Ti 装 NVLink 实录:单流零提升的真相,与 +31% 的正确打开方式
本文最后更新于 2026年9月26日 晚上
双 2080Ti 装 NVLink 实录:单流零提升的真相,与 +31% 的正确打开方式
断电、拆机、装桥、开机,NVLink 双链路满速验证通过——然后推理速度纹丝不动,只有待机功耗从 5W 涨到了 26W。这是一次从”白花钱”到”+31%”的完整调优实录,顺便踩穿了 llama.cpp tensor split 的三个深坑。
起点:一次看起来很成功的硬件升级
图灵机是台 2×RTX 2080Ti 22GB 的老伙计,跑 llama.cpp 推理服务。NVLink 桥装上后,验证一切正常:
nvidia-smi topo -m显示 GPU0↔GPU1 为 NV2(双链路绑定)nvidia-smi nvlink -s四条链路全部 25.78 GB/s 满速- 卡间带宽合计约 52 GB/s,是 PCIe 3.0 的三倍多
然后跑了一下 Qwen3.6-35B-A3B 和 Qwen3.8-27B,生成速度一点没变。功耗倒是实打实涨了——双卡待机从 5W 到 26W,这是 NVLink PHY 常驻活跃的电费,省不掉。
装了个寂寞?
为什么单流没提升:一笔 0.001% 的账
先说结论:在 layer split 模式下,NVLink 对单流推理就是没有用。这不是玄学,算一笔账就明白。
layer split(层切分)的工作方式:卡1算前半层,卡2算后半层。每个 token 前向时,卡间只传一次激活值。这个激活有多大?
| 项目 | 数值 |
|---|---|
| 每 token 卡间传输量 | hidden_size × 2B ≈ 4~8 KB |
| PCIe 3.0 传 8KB | ~0.7 µs |
| NVLink 传 8KB | ~0.15 µs |
| 每 token 生成间隔(按 7 tps) | ~150,000 µs |
| 通信时间占比 | <0.001% |
链路快四倍,也只是把 0.001% 变成 0.0003%。瓶颈根本不在链路,而在显存带宽、流水的串行等待(卡1算时卡2闲着)、以及 MoE 的路由开销。
所以真正的瓶颈清单是:layer split 模式下两卡是”轮流干活”而不是”一起干活”。要两卡同时算同一层,得换 tensor split(张量并行)。而 tensor split 的 allreduce 通信量随 batch 增长——那才是 NVLink 的主场。
第一次尝试就 OOM:tensor split 的三个坑
把 Qwen3.8-27B 改成 split-mode = tensor,第一次加载直接失败。排查下来是三个坑的叠加:
坑一:tensor 模式不做显存自动适配。 日志原文:llama_params_fit is not implemented for SPLIT_MODE_TENSOR。layer 模式会自动把参数塞进空闲显存,tensor 模式全靠手工配平。
坑二:ctx 大小和 mmproj 的分配冲突。 512K 上下文 + 888MiB 的视觉投影层(mmproj)叠加后,卡0 上最后一块 2384 MiB 分配失败。layer 模式下同样配置能跑,因为 KV cache 按层分到了两张卡;tensor 模式下分配方式完全不同。
坑三:切分比例不是越”优化”越好。 后来试过 48,52(想给卡0 留余量),结果触发 KV cache 整块 15GB 压到卡1,必爆。50,50 是验证过的唯一稳定组合。
最终解:tensor 50,50 + ctx 262144,卡0 16.4G / 卡1 15.2G,加载成功。
实测:+31% 和 +12%
同 ctx、同 prompt、max_tokens=256 热测(弃掉含模型加载时间的第一轮):
| 模型 | layer | tensor | 提升 |
|---|---|---|---|
| Qwen3.8-27B(dense) | 35.9 tps | 47.1 tps | +31% |
| Qwen3.6-35B-A3B(MoE) | 115 tps | 129.3 tps | +12% |
两个细节值得说:
dense 提升大于 MoE。 MoE 每 token 只激活 3B 参数,每层计算轻,layer 流水的损失本来就小,tensor 化的收益跟着缩水。dense 27B 每层算得重,轮流干活的浪费更明显。
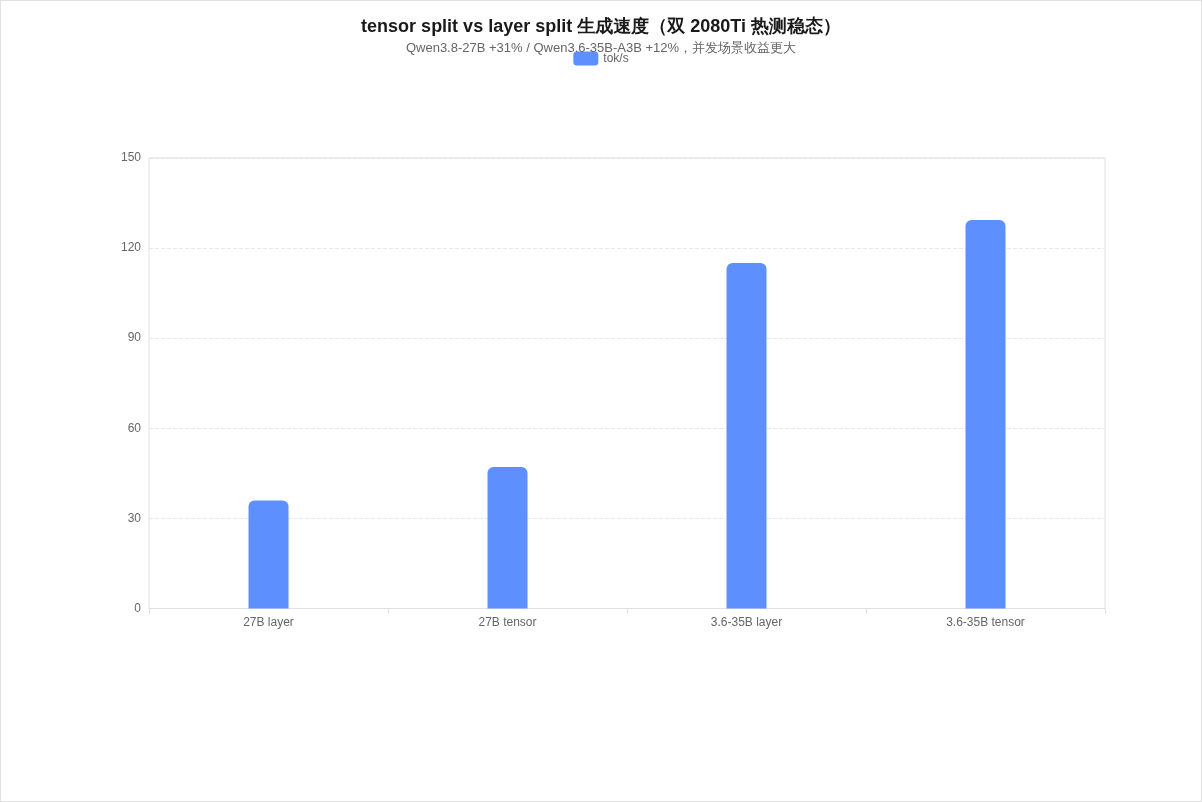
并发收益远大于单流数字。 单流 +12% 看着平平,但 layer 流水线在并发时气泡放大、多请求挤单通道;tensor 双卡逐层并行 + allreduce 走 NVLink,batch 越大效率越高。实际多路并发使用时,提速感受远超单流 benchmark 的数字。
冲击 1M 上下文:348 MiB 的极限拉扯
27B 降到 256K 是妥协,3.6-35B-A3B(MoE,KV cache 远小于 dense)可以更贪:ctx 1M + 4 并发槽。
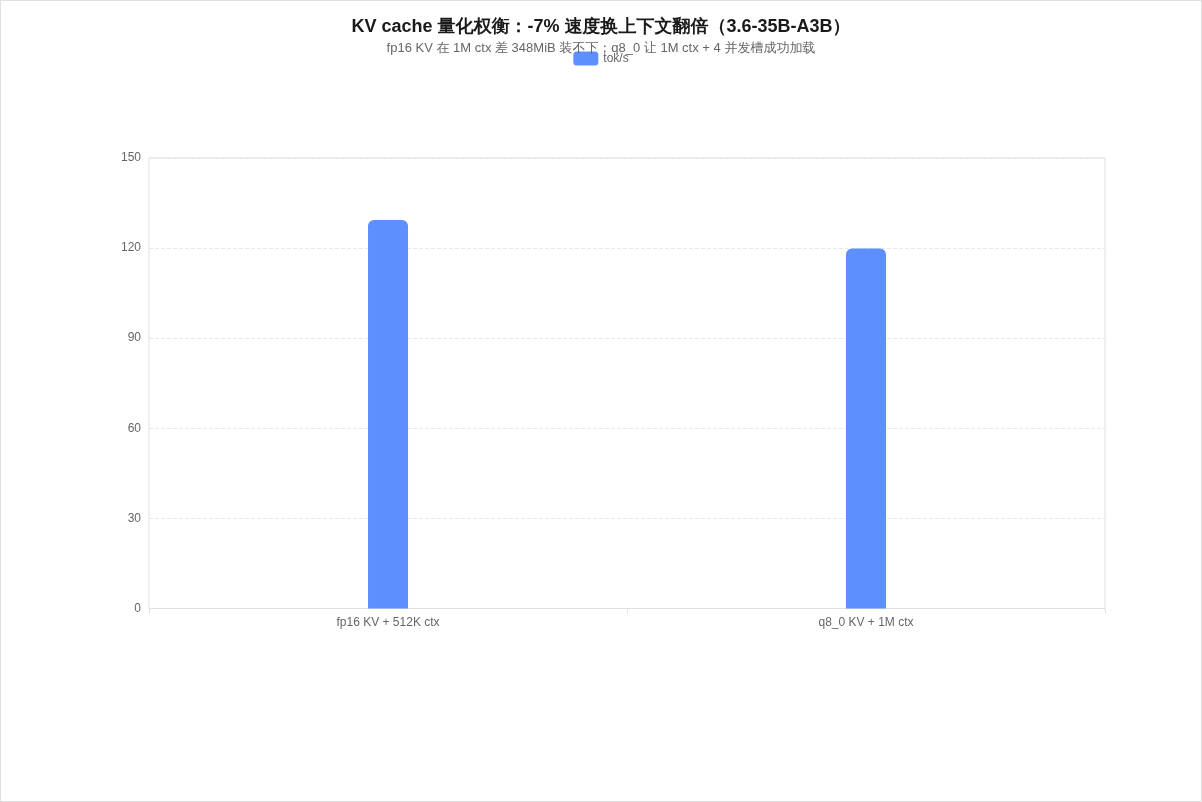
第一步直接上,失败——差 348 MiB,就差这么点。
第二步打开 KV cache 量化(ctk/ctv = q8_0):KV 显存直接减半,卡0 21.8G / 卡1 20.7G 贴满装下。代价是速度从 129.3 降到 ~120 tps(-7%,反量化开销),换来上下文翻倍。q8_0 是 8.5 bit 有效精度,perplexity 损失在 1% 以内,日常使用无感。这笔账划算。
中间还有个小插曲。某次改完配置重启,明明回滚到了验证过的 50,50 + q8_0,还是 OOM。而且失败数字和启用 q8_0 之前一模一样。查配置才发现 ctk/ctv = q8_0 被注释回去了——编辑器里开着旧版本缓冲,保存时把并行修改整个覆盖掉了。多人/多会话改同一个配置文件,动手前先重新打开文件,这是血泪教训。
最重要的发现:我们跑在一条官方不支持的路上
查资料时发现一个此前完全没意识到的问题:llama.cpp 上游官方至今不支持 tensor split + KV cache 量化的组合。官方代码会在初始化时直接拒绝:
1 | |
相关 issue(#21788)已关闭,修复 PR(#23912)未合并。我们的自编译版本显然带了这个社区补丁才能跑起来。这解释了 48,52 诡异 OOM 的根因——补丁路径未经官方验证,分配逻辑对参数敏感。
代价与对策:升级 llama.cpp 时补丁会丢,需要重打;参数上锁死 50,50 不再折腾;出诡异显存问题时先怀疑这条路。
总结:老卡焕新的完整路径
- NVLink 桥:单流无用(通信占比 0.001%),tensor split + 并发时兑现价值;代价是每卡 +10W 待机
- tensor split:dense 27B +31%,MoE +12%,并发感受更佳;但显存全手工配平,50,50 别乱动
- KV q8_0:速度 -7% 换 KV 显存减半,是冲击大 ctx 的钥匙;质量损失在噪声级
- MoE 优势:KV cache 远小于 dense,同显存能塞下更大的上下文
- 风险自担:tensor + KV 量化走的是非官方补丁路径,升级需重打,配置勿折腾
2×2080Ti 在 2026 年依然能打:双模型常驻,一个 1M 上下文 4 并发 @120 tps,一个 256K @47 tps,全链路 tensor 并行。老硬件的上限,比你以为的高。
参考文献
- llama.cpp issue #21788 — Allow SPLIT_MODE_TENSOR with KV cache quantization(官方不支持 tensor+KV 量化的原始记录)
- llama.cpp PR #23912 — –split-mode=tensor KV cache quantization support(未合并的社区修复)
- llama.cpp PR #1684 — k-quants(KV/权重量化的 perplexity 数据基础)